讓 RPG 敵人向玩家學習——2007 年的神經網絡原型
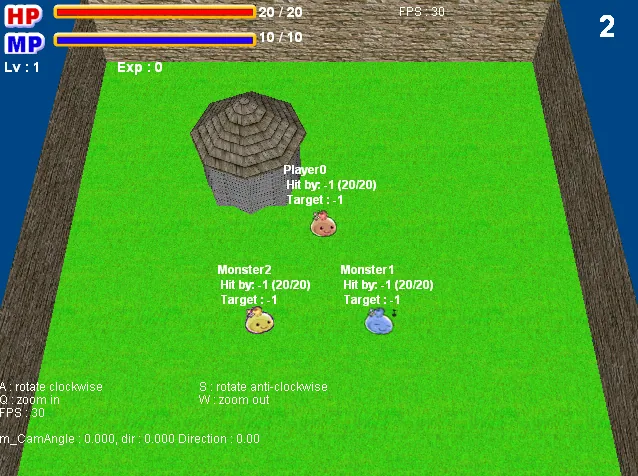
2007 年,我的工程學畢業專題提出了一個至今仍影響我工作的問題:敵人能否從玩家的行為中學習,而不是完全依照固定的腳本行事?
我以 C++ 和 DirectX 製作了一個小型 3D 動作 RPG 原型。玩家在競技場中以物理攻擊、法術、治療和目標鎖定,對抗一群史萊姆般的代理。在這個可遊玩的示範背後,是一個實驗性的神經網絡,負責決定 NPC 應該遊蕩、跟隨還是逃避。
我做了甚麼
這個項目結合了三個經常被分開處理的範疇:遊戲系統架構、即時圖像和機器學習。引擎使用 Win32 遊戲循環,分為初始化、更新和渲染三個階段,配合物件導向的角色控制器,約有 50 個 C++ 原始碼檔案和數量相若的標頭檔。
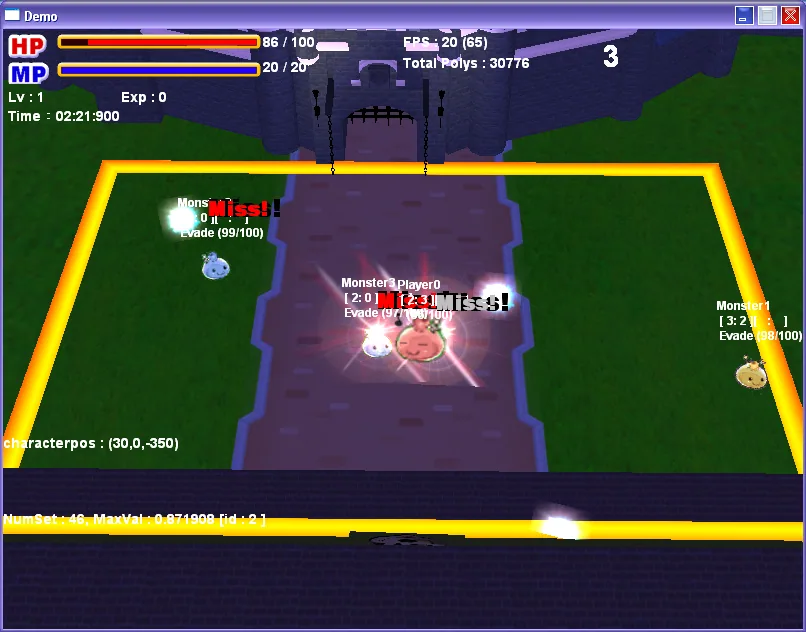
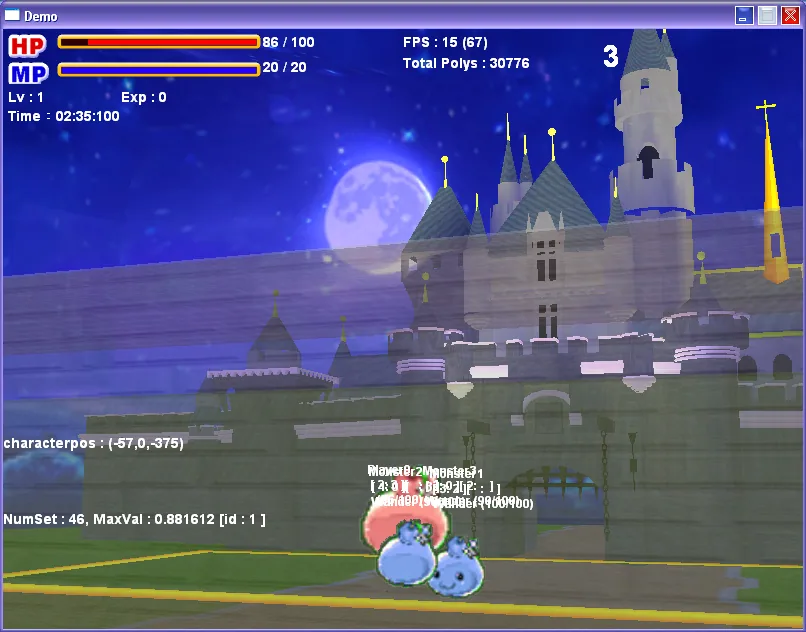
渲染方面包括 3D 世界中的 2D sprite、面向鏡頭的 billboard、動畫貼圖幀、alpha 混合和滑鼠選取。原型亦包括天空盒、光照、粒子效果、鏡頭遮擋、HP 和 MP 系統、幀率監察,以及每個代理的除錯資訊。
從零開始認識神經網絡
神經網絡是一個由許多細小單元(稱為神經元)組成的函數,單元之間以帶有權重的連結相連。每個神經元只做三件簡單的事:接收一些數字、把每個數字乘以對應的權重,然後加起來。
在原型中,每個輸入都會先縮放到 0 至 1 之間,避免距離這類數值天生較大的輸入,蓋過生命比例這類細小的數值。神經元的淨輸入就是加權總和:
X = x₁w₁ + x₂w₂ + … + xₙwₙ
這個總和仍要變成一個決定,這就是激活函數的工作。最簡單的是階躍函數:X 達到門檻 θ 便輸出 +1,否則輸出 −1。由於我希望輸出可以當作機率來理解,網絡改用 sigmoid,把任何數值壓縮成 0 至 1 之間的平滑曲線:
y = 1 / (1 + e−X)
把神經元排成多層,就成為項目所用的多層感知器(multi-layer perceptron)。資訊向前流動:由輸入層,經過一個或多個隱藏層,到達輸出層。連結上的權重就是網絡的長期記憶,而所謂學習,就是不斷調整這些權重,直至輸出變得有用。
每隻怪物體內的網絡
我刻意讓模型保持精簡,以便在遊玩期間訓練:四個輸入、一個有三個神經元的隱藏層,以及三個輸出。
- 輸入:與玩家的距離、怪物的生命比例、附近怪物的數目,以及牠的當前動作。
- 輸出:遊蕩、跟隨或逃避。激活程度最高的輸出,就是怪物在那一刻採取的動作。
網絡如何學習
訓練分為四個步驟,至今仍是大部分神經網絡訓練的骨幹。
- 初始化。所有權重和門檻都由細小的隨機數開始。網絡亦需要一個訓練集:一組組輸入,配上我們期望的輸出。在示範程式中,每個例子有四個輸入值和三個期望輸出,數值都在 0 至 1 之間,由人手編寫或從玩家身上擷取。
- 激活。把一個例子前饋輸入網絡,得出實際輸出。
- 學習。把實際輸出 y 與期望輸出 t 比較。兩者的差,即誤差 e = t − y,用來驅動 delta 規則 w ← w + α · x · e。學習率 α(一般為 0.01–0.1)在學習速度與對雜訊的敏感度之間取捨。反向傳播把誤差由輸出層傳回隱藏層,讓每個權重都分擔一部分修正。
- 迭代。轉到下一個例子,不斷重複,直至誤差降到可接受的水平。
把戰鬥變成訓練數據
遊戲不會自帶已標記的數據,所以報告探討了幾種從遊玩中產生數據的方法。
- 預測結果。遭遇戰開始時,網絡估計 NPC 獲勝的機率;如果結果是 NPC 落敗,該次預測的目標值便設為 0。經過幾十次權重更新後,這個估計就能成為合理的參考。
- 從錯誤中學習。如果怪物按網絡的建議行動卻因此死亡,該決定便被視為壞決定,網絡會被調整,在相同輸入條件下抑制這個選擇——這是一種簡單的強化學習。
- 起始規則。在學習之前,幾條人手編寫的規則讓網絡有合理的起點:攻擊命中玩家後停止追擊、生命值低時逃避、玩家身邊沒有其他怪物時便跟隨玩家。
更大的構想是模仿學習。在 AI 測試台中,開發者或玩家與代理對戰,遊戲同時記錄玩家的當前動作、敵人的距離、障礙物訊號,以及 HP/MP 比例。這些記錄成為訓練集,讓對手學會在相似情況下,像真人一樣作出回應。玩家與 AI 交換角色,又可以產生更多例子。
報告亦構想了下一步:以貝葉斯分析,從玩家的行為推斷對方是戰士、祭司還是法師,而不是讓 AI「作弊」直接讀取職業。這是一次早期的嘗試:把玩家行為視為遊戲數據,而不是人手編寫每一個反應。
實驗實際發現了甚麼
這個可適應系統很有潛力,但還未可靠到可以稱為完成。而這個結果,成為了整個項目最有用的部分。
- 加入更多隱藏層並沒有令代理變得更好。較深的版本變得更難預測,而且需要更多運算。
- 較小的網絡帶來更直接的對應,用於遊戲內實驗亦更實際;不過縮得太小同樣會產生差劣的決定。
- 在權重修正過程中加入動量(把上一次更新的一部分帶到下一次),改善了穩定性。
- 線上訓練非常依賴所擷取的玩家例子的質素和範圍。細小或雜亂的訓練資料無法產生令人信服的行為。
- 除錯的可見度很重要。顯示代理的狀態、目標、生命值和輸出,才令學習系統能在運行中的遊戲內被評估。
因此,這個原型展示了整條流程,以及學習類似玩家動作的可能性;同時亦顯示神經網絡並不會自動比人手編寫的行為更好。遊戲仍然需要清晰的輸入、可量度的結果、良好的訓練數據,以及保障玩家體驗的後備方案。
為何這個 2007 年的項目對我仍然重要
很多結論今天又再顯得切合時宜。今天我們可以建立更大的模型、收集更多數據,但互動 AI 仍然必須在遊戲循環中運行、向開發者解釋自己的狀態,並產生讓人覺得公平的行為。只有在改善玩家體驗時,複雜度才有幫助。
報告亦提出了圍繞模型的實用工具:AI 測試台、角色和地圖編輯器、效能分析、可編輯的遊戲數據,以及在遊玩期間更好地收集玩家屬性的方法。這些想法與我今天對 AI 輔助開發的看法一脈相承:有用的智能需要介面、迭代循環和清晰的創作目的。
存檔說明:這篇回顧根據我 2006–07 年工程學士畢業報告《AI Role Playing Game Development》撰寫,報告全文可在香港城市大學公開閱覽:閱讀完整報告(PDF)。截圖來自我為該項目製作的原型;圖解已重新繪製,文字亦為今天的網誌重新撰寫。
資料來源
- Chow Ying Kit(Rick Chow),AI Role Playing Game Development,計算機工程學工學士(榮譽)畢業專題報告,香港城市大學電子工程學系,2006–07 年。城大圖書館 PDF